NOTES
Jevとは?ChatGPT・Gemini・Claudeとの違いから、仕組み・使い方・料金まで無人店舗の開発目線で解説
Jev は ChatGPT・Gemini・Claude と何が違うのか。文章で答えるAIではなく、「どれか」「はい/いいえ」「段階のどこか」を確率つきで返す、TypeSafe AI の「System One モデル」です。違いの説明から、仕組み(校正された確率)、質問の書き方、始め方のコード、料金と9つの弱点まで、完全無人のセルフ写真館を運営する私が実際に使いながら解説します。
- ChatGPT・Gemini・Claude は文章で答えるAI。Jev は文章を書かず、「どれか」「はい/いいえ」「段階のどこか」だけを確率つきで返すAI。TypeSafe AI が2026年9月15日に公開した「System One モデル」
- 質問は3種類だけ。Choice(どれか)・Noul(はい/いいえの確率)・Score(段階のどこか)。1回のリクエストに何問でも並べられ、同時に答えが返る
- 確率は「校正」されている。0.8と返した答えは、たくさん集めると約8割が正しい、という意味で、しきい値をコードで引ける
- 入力100万トークン $0.042・出力無料・1リクエスト最大64kトークン。私の実測では1件0.25秒前後で、公式LINEの文面を全部通しても月に数円
- 計算・日付の比較・文章の生成はできない。主言語は英語。判断はコードが持ち、Jev は判断の材料を返す、という分担で使う
ChatGPT・Gemini・Claude は「文章で答えるAI」、Jev は「文章を書かずに、判断だけを返すAI」です。同じAIでも、仕事の種類がまったく違います。
たとえば、私の店の公式LINEに「鍵が開きません。店の前にいます」と届いたとします。 ChatGPT に「これは何の用件?」と聞けば、「入店のトラブルについてのお問い合わせのようです。まずは〜」といった調子で、文章で丁寧に答えてくれるはずです。 Jev に同じことを聞くと、返ってくるのはこれだけです。
| 選択肢 | Jev の答え |
|---|---|
| 困りごと(鍵・入店・機器) | 100% |
| 予約 | 0% |
| 料金などの質問 | 0% |
文章は1文字もありません。こちらが先に用意した選択肢のうち、どれがどのくらい当てはまるか。それだけです。 人が読むなら ChatGPT の答えのほうが親切ですが、プログラムが受け取るなら Jev の答えのほうが扱いやすい。 「100%なら困りごとの案内を出す」と、そのまま条件にできるからです。
| ChatGPT・Gemini・Claude | Jev | |
|---|---|---|
| 答え方 | 文章 | 選択肢の確率・はい/いいえの確率・段階 |
| 得意なこと | 書く・要約する・説明する・相談に乗る | 仕分ける・判定する・点をつける |
| 答えの形 | 頼み方しだいで崩れることがある | 決めた形から外れない |
| 速さ(私の実測) | 数秒かかることもある | 約0.25秒 |
| 使う人 | 人が直接話しかける | 主にプログラムから呼ぶ |
| できないこと | — | 文章を書く・理由を説明する・計算する |
つまり、ChatGPT の代わりになるものではありません。 「文章は要らないけれど、判断は大量に、速く、安くしたい」ところに置く、別の道具です。 私の店でいえば、届いた問い合わせを仕分ける、アンケートの感想に点をつける、AIチャットの回答がまずいことを言っていないか確かめる。 どれも、文章ではなく判断が欲しい場面です。

Jev は、TypeSafe AI が2026年9月15日に公開した「文章を書かないAI」です。同社はこの種類のモデルを「System One モデル」と呼んでいて、Jev はその最初の1つ。 こちらが渡した文脈(state)に対して、決まった形の質問に、確率つきで答えます。 返ってくるのは文章ではなく、「どれか」「はい/いいえ」「段階のどこか」と、その確からしさだけです。
開発の目線でいうと、ChatGPT などに「このメッセージを5つに分類して、JSONで返して」と頼んだときについてくる、 返事を解析して形が崩れていないか、6つ目の分類を作っていないかを確かめる作業が、Jev には要りません。 選択肢を5つ渡せば、5つの確率が返るだけ。存在しない答えを返すことは、仕組み上できません。
公式ブログによると、TypeSafe は2年間表に出ずに開発を続け、今回アーリーアクセスとして公開しました。 創業者は OpenAI で、AIに指示を聞かせる手法の開発に関わっていた人です。利用はウェイトリスト制で、 私の店は9月に承認されて使えるようになりました。
名前の元は、心理学者ダニエル・カーネマンの「システム1・システム2」です。 人の頭には、ぱっと判断する速い思考(システム1)と、じっくり考える遅い思考(システム2)がある、という考え方。 いまの LLM は、文章を書き、理由を述べ、段取りを考える「システム2」側の道具です。 Jev は反対に、考え込まずに、ぱっと決めるほうだけを担います。
速さ — 1回の往復が0.1〜0.5秒
文章を1文字ずつ生成しないので、速い。公式ブログは、応答を端から端まで70〜500ミリ秒、 同じ種類の判断で最先端の LLM より40〜200倍速い、としています。 ただしこれは TypeSafe 自身が作った評価での数字です。私が福島から測ったときは、質問3つで中央値251ミリ秒でした(第2回)。
確率が「校正」されている、とはどういうことか
Jev の説明で一番大事なのがここです。公式のドキュメントは、Jev の確率は校正(キャリブレーション)されていると言います。 意味は、「0.8と答えたものを100件集めると、だいたい80件が正しい」。 0.2なら2割、1.0ならほぼ全部。確率が、実際の当たりやすさと揃うように訓練されている、ということです。
ChatGPT に「確信度を0〜1で答えて」と頼めば数字は返ってきますが、それは作文された数字で、当たりやすさと揃っている保証はありません。 公式は、人の好みに合わせる訓練(RLHF)は「自信のありそうな間違い」を生みやすいと説明し、 Jev には判断と確率を返すための別の訓練(RLCD:Reinforcement Learning for Calibrated Decisions)を使ったとしています。
確率が当てになるなら、しきい値をコードで引けます。 「0.9以上なら自動で進める、それ未満は人が見る」。これができるのが、Jev を仕組みに組み込めるかどうかの分かれ目です。
出典:TypeSafe 公式ブログ「Introducing System One Models & Jev」(2026年9月15日)、公式ドキュメント「System One」「AI primer」(2026年9月22日取得)
Jev に聞ける質問は3種類しかありません。自分の判断をこの3つのどれかに言い直せるか、が使えるかどうかの境目です。
| 型 | 聞くこと | 返るもの | 私の店での例 |
|---|---|---|---|
| Choice | 選択肢のうちどれか | 選んだ1つ、選択肢ごとの確率、confidence | この文面の用件は、困りごと・写真・予約・場所・料金のどれか |
| Noul | この条件は成り立つか | 「はい」の確率(0〜1) | 送り主は今、店の前で詰まっているか |
| Score | 段階のどこか | 段階の番号の重みつき平均、段階ごとの確率、confidence | この感想はどのくらい満足しているか(4段階) |
Choice — 順番の無い選択肢から1つ
選択肢に名前と説明を付けて渡します(最大255個)。返ってくるのは、選ばれた1つと、全選択肢の確率。 大事なのは説明文で、Jev は名前ではなく説明を読んで当てはめます。「trouble」だけでなく「今その場で困っている。鍵・入店・機器が動かない」まで書く。
Noul — はい/いいえを確率で
1つの条件が成り立つ確率を0〜1で返します。はい/いいえの2択なので、確率そのものが確からしさで、confidence は付きません。 書き方のコツは公式に4つあります。
- 1問に1つの条件だけ。「怒っていて、かつ返金を求めているか」は2問に分ける
- 「はい」が高い値になる向きで書く。「個人情報が含まれていないか」ではなく「含まれているか」
- 境目が曖昧なら、「はい」と「いいえ」それぞれの説明(criteria)を添える
- 0.2〜0.8の中間の値は、自動で振り分けずに人が見る候補にする
Score — 順番のある段階のどこか
2〜10個の段階を、低い順に並べて渡します。返る score は「段階の番号×その確率」の合計で、段階と段階の間の値にもなります。 たとえば3段階(0・1・2)で score が1.43なら、1と2の間で1寄り、という意味です。
注意点は、同じ score でも中身が違うことがある点です。1.0は「全部が段階1」でも「段階0と2に半分ずつ」でも出ます。 だから score だけでなく、段階ごとの確率と confidence を一緒に見ます。 もう1つ、公式は段階を「中くらい」のような程度の言葉ではなく、具体的な状況で書くよう勧めています。 Jev は段階の番号も隣の段階も見ずに、1つずつ文脈と照らすからです。
confidence — 迷っている度合い
Choice と Score には confidence(0〜1)が付きます。確率が1つに集中していれば1に近く、割れていれば低くなります (選択肢が3つなら「(3×一番大きい確率−1)÷2」)。 公式は、0.9以上は自動、0.5〜0.9は確認を挟む、0.5未満は人に回す、を目安に挙げていて、取り返しのつく操作としつかない操作で、しきい値を変えることを勧めています。
出典:TypeSafe 公式ドキュメント「Primitives」「Choice」「Noul」「Score」「Confidence」(2026年9月22日取得)
state — 判断してほしい材料をまとめて渡す
state には、文字列・JSON のオブジェクト・文字列の配列のどれでも渡せます。 1つの文面だけなら文字列、注文番号やお店の方針と一緒に判断させたいならオブジェクト、会話の流れなら配列。 質問の中から `answer` のように、state の中の項目をバッククォートで名指しできます。
公式が強調しているのは2つ。判断に要るものは一緒に入れる(方針と照らすなら、方針も state に入れる)。 そして関係ないものは入れない。関係ない文脈が多いと精度が落ちると、弱点の一覧にも書かれています。 入力はテキストだけで、画像や音声は渡せません。
質問 — 狭く、たくさん、1回で
公式の設計ガイドの芯はこれです。「これは迷惑メールか?」と大きく1問で聞くのではなく、 「パスワードを求めているか」「送り主の名前とアドレスが食い違っているか」「急がせているか」のように、1つの性質だけを聞く狭い質問に分ける。同じ state への質問は1回のリクエストで並行に答えが返るので、 質問を増やしても往復は増えません。
分けておくと、どの判断がずれたかが見え、重みも後から変えられます。 たとえば採用の書類選考なら、「Python の深さ」「チームを率いた経験」「設計の経験」を別々の Score で聞いて、 職種ごとに重みを変えて足し合わせる(公式の「composite scoring」)。1つの総合点で聞くと、この調整ができません。
判断はコードが持つ
TypeSafe の考え方は一貫していて、流れと副作用(送る・書き込む・開ける)はコードが持ち、Jev には狭い判断だけを任せる。 AIが自分で次の手を決めて動き回る「エージェント」の作りとは逆です。 私の店でいうと、こうなります。
topic = r.choices["topic"]
if topic.confidence >= 0.9:
    send_guide(topic.choice)      # 用意してある案内を返す(作文はしない)
else:
    send_guide("general")         # 迷ったら一般の案内に落とす
    keep_for_owner(message)       # 文面は人が後で読む
出典:TypeSafe 公式ドキュメント「State」「How to build with TypeSafe」「Composite scoring」(2026年9月22日取得)
- 1typesafe.ai でウェイトリストに登録し、承認を待つ(私は9月に承認)
- 2console.typesafe.ai にログインし、「API Keys」でキーを作る。キーは組織単位で、作った人が抜けても有効なまま
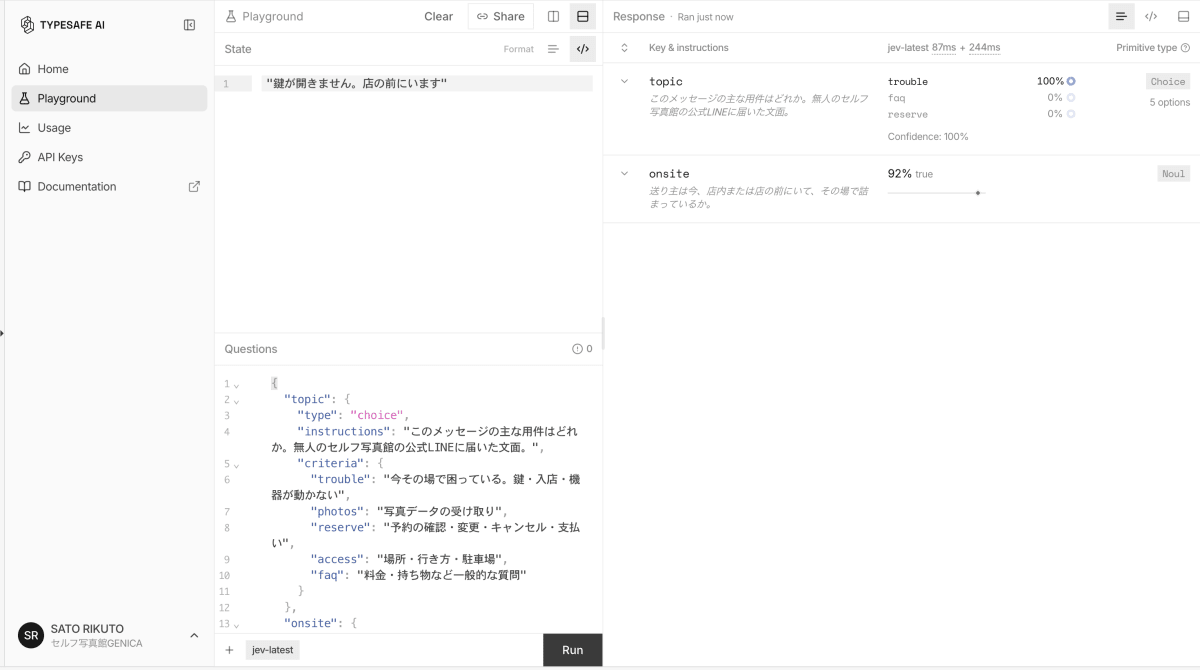
- 3まず「Playground」で、コードを書かずに state と質問を試す(上のスクリーンショット)
- 4キーを環境変数
TYPESAFE_API_KEYに入れ、SDK を入れる - 5state と質問を渡して呼ぶ
pip install typesafe-sdk          # Python
npm install @typesafe-ai/sdk      # JavaScript(Node.js 20以上)
私が最初に動かしたのは、公式LINEに届く文面の用件と、「その場で詰まっているか」を1回で聞くコードです。
from typesafe_sdk import TypeSafeClient, Choice, Noul

client = TypeSafeClient()  # 環境変数 TYPESAFE_API_KEY を読む

r = client.system_one(
    state="鍵が開きません。店の前にいます",
    questions={
        "topic": Choice(
            instructions="このメッセージの主な用件はどれか。",
            criteria={
                "trouble": "今その場で困っている。鍵・入店・機器が動かない",
                "photos": "写真データの受け取り",
                "reserve": "予約の確認・変更・キャンセル・支払い",
                "access": "場所・行き方・駐車場",
                "faq": "料金・持ち物など一般的な質問",
            },
        ),
        "onsite": Noul(
            instructions="送り主は今、店内または店の前にいて、その場で詰まっているか。"
        ),
    },
)

print(r.choices["topic"].choice)         # trouble
print(r.choices["topic"].confidence)     # 1.0
print(r.choices["topic"].probabilities)  # {'trouble': 1.0, 'photos': 0.0, ...}
print(r.nouls["onsite"].noul)            # 0.92
print(r.usage.input_tokens)              # 入力トークン数(料金の元)
HTTP で直接呼ぶ場合は、https://api.typesafe.ai/v1/systemone にAuthorization: Bearer キー を付けて、state・model(jev-latest)・questions を JSON で送ります。 エラーは401(キーが違う)、422(リクエストの形が違う)、429(レート制限)、529(混雑)で、429と529は間隔を空けて再送します。
TypeSafe は Claude Code 用のスキルを公開しています。claude plugin marketplace add typesafe-ai/skills のあとclaude plugin install typesafe@typesafe-ai で入り、以後「TypeSafe のスキルを使って」と頼めば、 質問の設計を公式の考え方に沿って手伝ってくれます。
出典:TypeSafe 公式ドキュメント「Quick start」「API reference」「Client SDKs」「Agent skill」(2026年9月22日取得)
| 項目 | 2026年9月時点 |
|---|---|
| モデル | jev-1.13.0(jev-latest・jev-preview も同じ) |
| 料金 | 入力100万トークン $0.042、出力は無料 |
| 1リクエスト | 最大64kトークン(state と一番長い質問で32kまで) |
| レート | 1分1,200リクエスト、1秒25万トークン(混雑で変わる) |
| 入力 | テキストのみ(文字列・JSON・文字列の配列) |
| 言語 | 主言語は英語。CJK は「扱えるが同等ではない」 |
| データ | リクエストを学習に使わない |
| ほかの入口 | Cloudflare の AI にも typesafe/jev として掲載 |
私の店の規模だと、費用は問題になりません。公式LINEの文面1件に質問3つで平均550〜680トークン。 月に数百件届いても、全部に通して数円です。
公式が自分で書いている弱点
好感を持ったのは、公式ドキュメントがモデルの弱点を9つ、率直に並べていることです。要約するとこうなります。
| 弱点 | 公式のすすめる避け方 |
|---|---|
| 書かれた文字どおりに読む(意図を汲まない) | 条件を正確に、具体的に書く |
| 計算・数を数えるのが苦手 | 計算はコードでやる |
| 日付や時刻を大小で比べられない | 日付の抜き出しは任せ、比べるのはコード |
| 二重否定や、何段もたどる推論に弱い | 指示をできるだけまっすぐ書く |
| 関係ない文脈が多いと精度が落ちる | コードで絞ってから渡す |
| 仕込まれた指示や誘導に引っ張られる | 選択肢の説明をはっきり書き、よく試す |
| 指示と選択肢が食い違うと混乱する | 両者の言葉を揃える |
| 「はい」と「いいえ」の確率の足し算が1になる保証がない | 質問はまっすぐ書き、しきい値を質問の型をまたいで使い回さない |
| 文章の生成はできない | 抜き出しは、限られた選択肢から選ぶ形にする |
1つ目は、私の実験でもそのまま出ました(第2回)。「方針に書かれていない、または矛盾する事実か」と聞いたら、 正しいけれど方針の文面に載っていないだけの回答にも「はい」が付いたのです。LLM なら汲んでくれる曖昧さを、Jev は汲みません。
出典:TypeSafe 公式ドキュメント「Models」「Jev 1.13 jaggedness」(2026年9月22日取得)、Cloudflare のモデルページ「Jev (typesafe)」
私の店は完全無人で、お客様への案内は「作文しない」と決めています。 その場で返事ができない店が、それらしい文章を自動で返すと、お客様は「伝わった」と思って待ってしまう。 無人店ではそれが一番まずい事故だからです。だから店の仕組みは、文面から行き先だけを決めて、用意してある案内へ送る形にしています。 いまその行き先を決めているのは、言葉のリストです。
これが Jev の形とぴったり同じでした。作文はしない、決めるのは「どれか」だけ。 そのうえで、言葉のリストでは拾えない「福島駅からどうやって行けばいいですか」(「行き方」も「場所」も入っていない)のような文面を、意味で拾える。 店の仕組みの中から「答えの形が決まっている判断」を洗い出すと、6つありました。
| 判断 | 聞き方 | 今のやり方 | 変わること |
|---|---|---|---|
| 公式LINEの文面の用件 | Choice+Noul | 言葉のリスト | 意味で拾える。正解25→38件(40件中・第2回) |
| 問い合わせフォームの用件(お客様か、取材・営業か) | Choice | 送り手が選ぶ | 選び間違いをこちらで直せる |
| 撮影後アンケートの自由記述 | Score+Choice+Noul | 人が読む | 満足度・話題・改善点の有無が集計できる列になる |
| サポートAIの回答の検証 | Noul+Choice | プロンプトで禁止するだけ | 「すぐ向かいます」のような守れない約束を、送る前に止める |
| 管理画面の受信箱の優先度 | Score | 届いた順 | 平日に見る余裕が無いとき、重いものから見られる |
| 全国のセルフ写真館の情報の分類 | Noul | 人の目 | 「完全無人か」の一次判定を任せ、迷った店だけ人が見る |
置かない場所
- 解錠・返金・予約の確定。取り返しのつかない操作の可否を、確率だけで決めない。 Jev が「困っている0.93」と言っても、扉を開けるのはお客様本人の手続きの中でだけ
- 料金の計算、日時の比較。苦手と公式に書いてある。コードがやる
- お客様に見せる文章。そもそも作れないし、作らせない
次の第2回では、公式LINEに届く想定の文面40件で、言葉のリストと Jev を実際に比べます。日本語で指示した場合と英語で指示した場合の差、外れた2件の中身まで。第3回は、使ってみた感想です。
この記事の調べ方
仕組み・料金・制限は、TypeSafe の公式ブログと公式ドキュメントを2026年9月22日に読んで確認しました。 資金調達の額など、公式で確かめられなかったことは書いていません。 応答時間・トークン数・精度は、私の店の文面で実際に API を叩いた結果です。 検証のコードはいつものように AI のコーディング支援に書いてもらい、何を聞くかの設計、正解づけ、結果の読み取りは私がやりました。 TypeSafe 社とは関係がなく、紹介料も受け取っていません。
自分の店のどの判断に置けるかを一緒に考えたい方は、LINEでのご相談も受け付けています。
よくある質問
Jev は ChatGPT・Gemini・Claude と何が違うのですか?
ChatGPT・Gemini・Claude は、質問に文章で答えるAIです。Jev は文章を書かず、こちらが用意した選択肢のどれに当てはまるか、はい/いいえのどちらか、何段階のどこかを、確率つきで返します。人と会話する道具ではなく、プログラムの中で「仕分ける・判定する・点をつける」ための道具で、私の実測では1回0.25秒前後でした。代わりに、文章を書く・理由を説明する・計算することはできません。
Jevとは何ですか?
Jev は TypeSafe AI が2026年9月15日に公開したAIモデルで、同社が「System One モデル」と呼ぶ新しい種類の最初のモデルです。ChatGPT のように文章を生成するのではなく、渡した文脈(state)に対する「どれか(Choice)」「はい/いいえ(Noul)」「段階のどこか(Score)」の質問に、確率と confidence(確からしさ)つきで答えます。2026年9月時点のモデルは jev-1.13.0 で、利用はウェイトリスト制です。
Jev の使い方は?
ウェイトリストが承認されたら、console.typesafe.ai で API キーを作り、環境変数 TYPESAFE_API_KEY に入れます。Python なら pip install typesafe-sdk、JavaScript なら npm install @typesafe-ai/sdk(Node.js 20以上)。state(判断してほしい文章やデータ)と質問を渡して system_one を呼ぶと、質問ごとの答えと確率が返ります。ブラウザのプレイグラウンドで、コードを書かずに試すこともできます。
Jev の料金はいくらですか?
2026年9月時点で、入力トークン100万あたり $0.042、出力トークンは無料です。1リクエストは最大64kトークン、レート制限は1分1,200リクエスト(変動あり)。私の実測では、LINEの文面1件に質問3つで平均550〜680トークン、101リクエストで $0.0026 でした。
Jev は日本語で使えますか?
使えます。公式は、主言語は英語で、CJK を含む他の言語は「扱えるが同等ではない」と説明しています。私が日本語の文面40件で試したところ、日本語で指示して38件、英語で指示して39件が正解で、答えは38件が同じでした(連載第2回)。用途ごとに自分のデータで確かめてから使うのが前提です。
Jev は Cloudflare からも使えますか?
Cloudflare の AI のモデル一覧に、サードパーティのモデルとして typesafe/jev が掲載されています(jev-1.13.0、コンテキスト32,000トークン)。料金は Cloudflare のダッシュボードで確認する形です。私は TypeSafe の API を直接使っています。
ほかの記録
← 記録の一覧へ